Describe los síntomas y confirma lo que realmente ocurrió
Empieza por señales observables: una tarea que no terminó, un resultado inesperado o una diferencia entre el registro de la automatización y el destino de la acción. Indica dónde confirmar cada señal y qué información recoger. La descripción debe separar lo observado de la explicación pendiente de verificar, evitando que la primera sospecha se trate como una causa confirmada.
“Está todo parado” ayuda poco a quien recibe la petición. Resulta más útil indicar qué proceso está afectado, cuándo apareció la primera señal y qué resultados dejaron de llegar. Añade el último caso que sabes que terminó correctamente, sin asumir que todos los siguientes fallaron de la misma forma o en la misma etapa.
Imagina una empresa ficticia cuya automatización recibe solicitudes de contacto, crea un registro y envía una confirmación. El equipo encuentra solicitudes sin confirmación de envío. Ese síntoma admite situaciones diferentes: el envío puede haber fallado, puede estar pendiente o puede haberse realizado sin que la respuesta del servicio haya llegado al registro interno.
El procedimiento debe indicar dónde comprobar la solicitud original, el registro creado y el estado del mensaje en su destino. Una ejecución marcada como fallida puede haber completado etapas anteriores. Antes de volver a ejecutarlo todo, hay que entender qué ocurrió para que el intento de recuperación no cree contactos ni mensajes duplicados.
Registra una referencia estable para cada caso afectado, la hora con su zona horaria y la versión del flujo que estaba funcionando. Vincula esos elementos al incidente en un lugar accesible para las personas responsables. La capacidad de explicar un cambio realizado por una automatización depende de esa relación entre datos, reglas y acción realmente ejecutada.
También es necesario delimitar el alcance del incidente. Puede afectar solo a una categoría de solicitudes o a todas las entradas nuevas desde un cambio determinado. Si todavía no conoces ese alcance, indica que está pendiente de confirmar y define quién lo comprobará, en lugar de comunicar una conclusión que los registros disponibles aún no respaldan.
Para preparar el siguiente paso, consulta Automatización de procesos empresariales.
Define cómo contener los efectos y quién puede decidir
Indica las acciones de contención permitidas, quién debe ejecutarlas y qué situaciones requieren otra decisión. Explica cómo suspender la parte afectada sin perder solicitudes y cómo confirmar el efecto de esa suspensión. El procedimiento debe incluir un sustituto y un canal de contacto para que la ausencia de una persona no deje al equipo sin orientación ante el incidente.
En el ejemplo ficticio, puede tener sentido suspender los envíos automáticos mientras se confirma el estado de los mensajes. Eso no implica necesariamente cerrar el formulario o dejar de recibir solicitudes. La decisión depende de poder conservar las entradas e impedir que el trabajo pendiente siga produciendo el efecto que se está investigando.
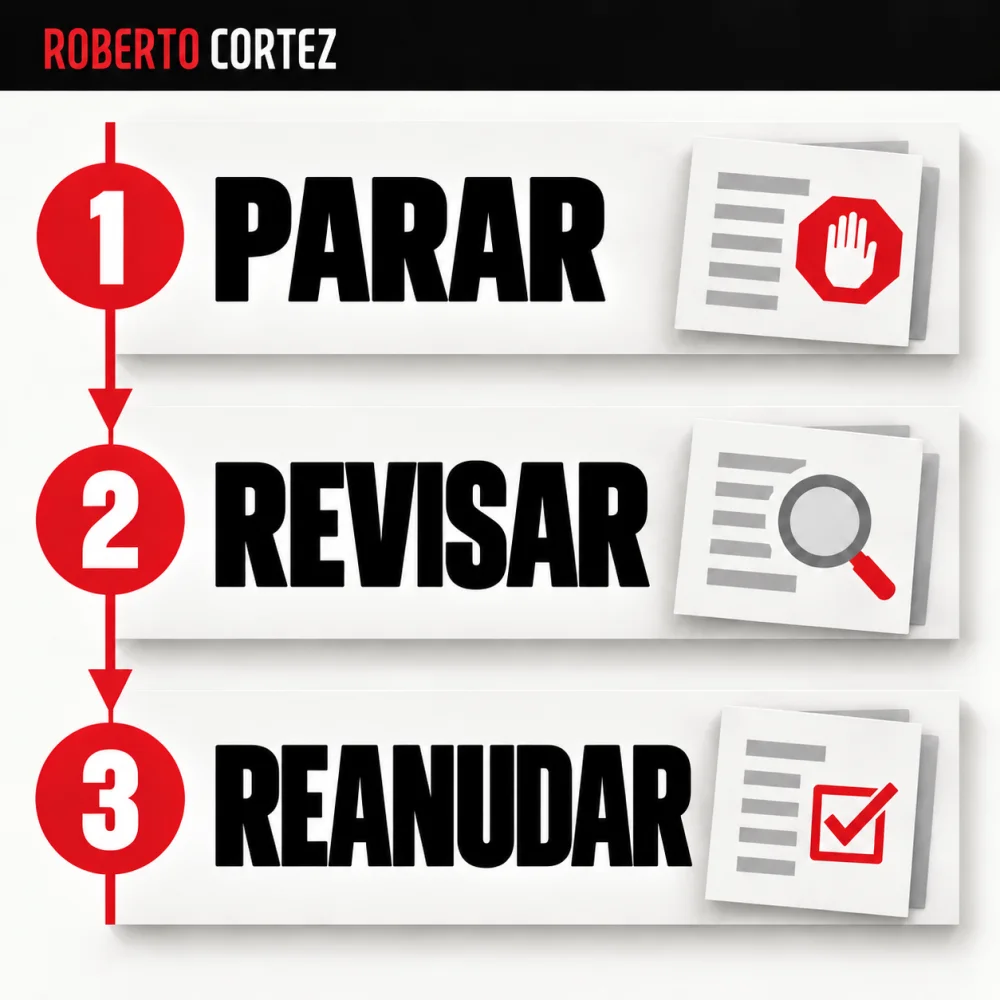
El registro debe distinguir entre detener nuevas ejecuciones e interrumpir trabajo que ya está en curso. El equipo necesita conocer el comportamiento de su sistema y verificar qué sigue activo. Una indicación visual de pausa no basta para concluir que no puede producirse ninguna acción en una etapa que ya se había iniciado.
Define también qué puede hacer la persona de seguimiento sin una nueva autorización. Puede señalar casos, suspender una etapa prevista en el procedimiento o pedir apoyo. Cambiar reglas comerciales, borrar registros o reenviar mensajes a clientes exige criterios propios y una decisión explícita de quien tiene responsabilidad sobre esas acciones y sobre sus consecuencias.
Los límites definidos antes de que una automatización cambie un presupuesto muestran por qué la autonomía necesita un alcance claro. Durante un incidente, la urgencia no aclara quién puede decidir. Esa definición debe existir antes, incluida la forma de escalar el caso cuando el efecto observado supera lo que el equipo de seguimiento puede resolver.
La comunicación interna debe indicar el impacto conocido, la contención aplicada, la persona responsable y el próximo momento de actualización. Si hay clientes afectados, alguien debe decidir qué comunicarles según los hechos confirmados. No prometas una hora de resolución que todavía no puedes justificar ni confundas la falta de información con la ausencia de impacto.
Conserva evidencias y organiza el trabajo pendiente
Guarda el estado observado, los mensajes de error relevantes, los cambios recientes y las intervenciones realizadas durante la respuesta. Organiza los casos como completados, pendientes o por confirmar, con un responsable para cada grupo. Conservar esa información permite investigar sin depender de la memoria y coordinar una alternativa manual sin superponer trabajo a lo que la automatización ya ejecutó.
El registro del incidente debe mostrar una secuencia comprensible. Anota cuándo se detectó, qué se suspendió y qué comprobaciones se realizaron antes de modificar el flujo. Mantén las hipótesis separadas de los hechos, incluida una hipótesis descartada cuando ayude a otra persona a entender por qué se eligió una intervención concreta y qué información la respaldaba.
Conserva solo la información necesaria en el lugar adecuado. Los identificadores y las referencias pueden bastar para encontrar un caso en los sistemas autorizados. Evita distribuir datos de clientes, credenciales o mensajes completos por conversaciones abiertas, sobre todo cuando basta con indicar la referencia que la persona responsable puede consultar con los accesos existentes.
Si la empresa ficticia decide responder manualmente a las solicitudes, cada respuesta debe quedar anotada en la misma lista de seguimiento. De lo contrario, el equipo podría completar el trabajo y la automatización volver a ejecutarlo al reactivarse. La alternativa manual debe permitir marcar lo realizado y excluir esos casos de la repetición prevista.
Un caso sin confirmación merece un estado propio. No lo marques como completado para reducir la lista ni como fallido solo para justificar otro intento. Comprueba el destino y, si persiste la incertidumbre, remite la decisión a quien pueda evaluar las consecuencias de esperar, contactar con el destinatario o realizar otra acción para resolverlo.
La persona que investiga la causa y quien sigue las solicitudes necesitan compartir el mismo estado. Pueden tener funciones diferentes, pero deben saber qué cambió y quién está tratando cada caso. Esa coordinación permite continuar el trabajo posible sin convertir la recuperación en intervenciones simultáneas cuya secuencia y cuyos efectos nadie consigue reconstruir después.
Reanuda con criterios y convierte el incidente en una mejora
Define qué debe verificarse antes de reactivar el flujo: corrección validada, casos pendientes conciliados, responsables informados y seguimiento preparado. Empieza por un conjunto controlado y observa el resultado en el destino. La reanudación necesita una persona que la autorice y una condición de nueva suspensión si vuelve a fallar el comportamiento esperado o reaparece el síntoma que motivó la intervención.
No consideres resuelto el incidente solo porque desapareció el mensaje de error. En el ejemplo, hay que confirmar que las nuevas solicitudes crean los registros correctos y reciben la confirmación prevista una sola vez. También es necesario comprobar el tratamiento de las solicitudes antiguas, porque corregir el flujo no completa automáticamente el trabajo pendiente.
La comprobación puede aprovechar los criterios utilizados para probar una automatización antes de entregarla al equipo. Durante la recuperación, añade la revisión del estado real de las acciones ya ejecutadas. Una prueba con datos nuevos no demuestra por sí sola que sea seguro repetir todos los casos que aparecen como incompletos en el historial del proceso.
Registra quién autorizó la reanudación, en qué condiciones y qué se observó después. Si quedan casos en investigación, mantén visible esa tarea pendiente y asígnale un responsable. La operación puede volver a funcionar mientras continúa parte del análisis, siempre que esa distinción se comprenda y no oculte trabajo que todavía necesita una decisión.
Después, revisa el procedimiento con quienes lo utilizaron. Identifica instrucciones ausentes, accesos que faltaron y dudas que retrasaron la respuesta. Actualiza el documento y prueba el cambio en un escenario controlado, conservando la versión anterior para comprender qué cambió y evitando convertir una solución local en una regla general sin comprobar antes su alcance.
Quiero que el equipo pueda responder a un fallo con un razonamiento compartido. Reconocer síntomas, limitar efectos, conservar el estado y decidir la reanudación forman parte de ese trabajo. Un procedimiento útil reduce la improvisación y permite verificar la respuesta, sin prometer que cualquiera resolverá todos los incidentes o que el servicio nunca sufrirá interrupciones.